Prompt | Kam až sahá čínská cenzura AI
V novém díle podcastu Prompt se díváme na to, co si čínské jazykové modely nesou ve svých vahách a proč by to mělo zajímat i evropské uživatele.
Podcast
PromptPrompt | Kam až sahá čínská cenzura AI
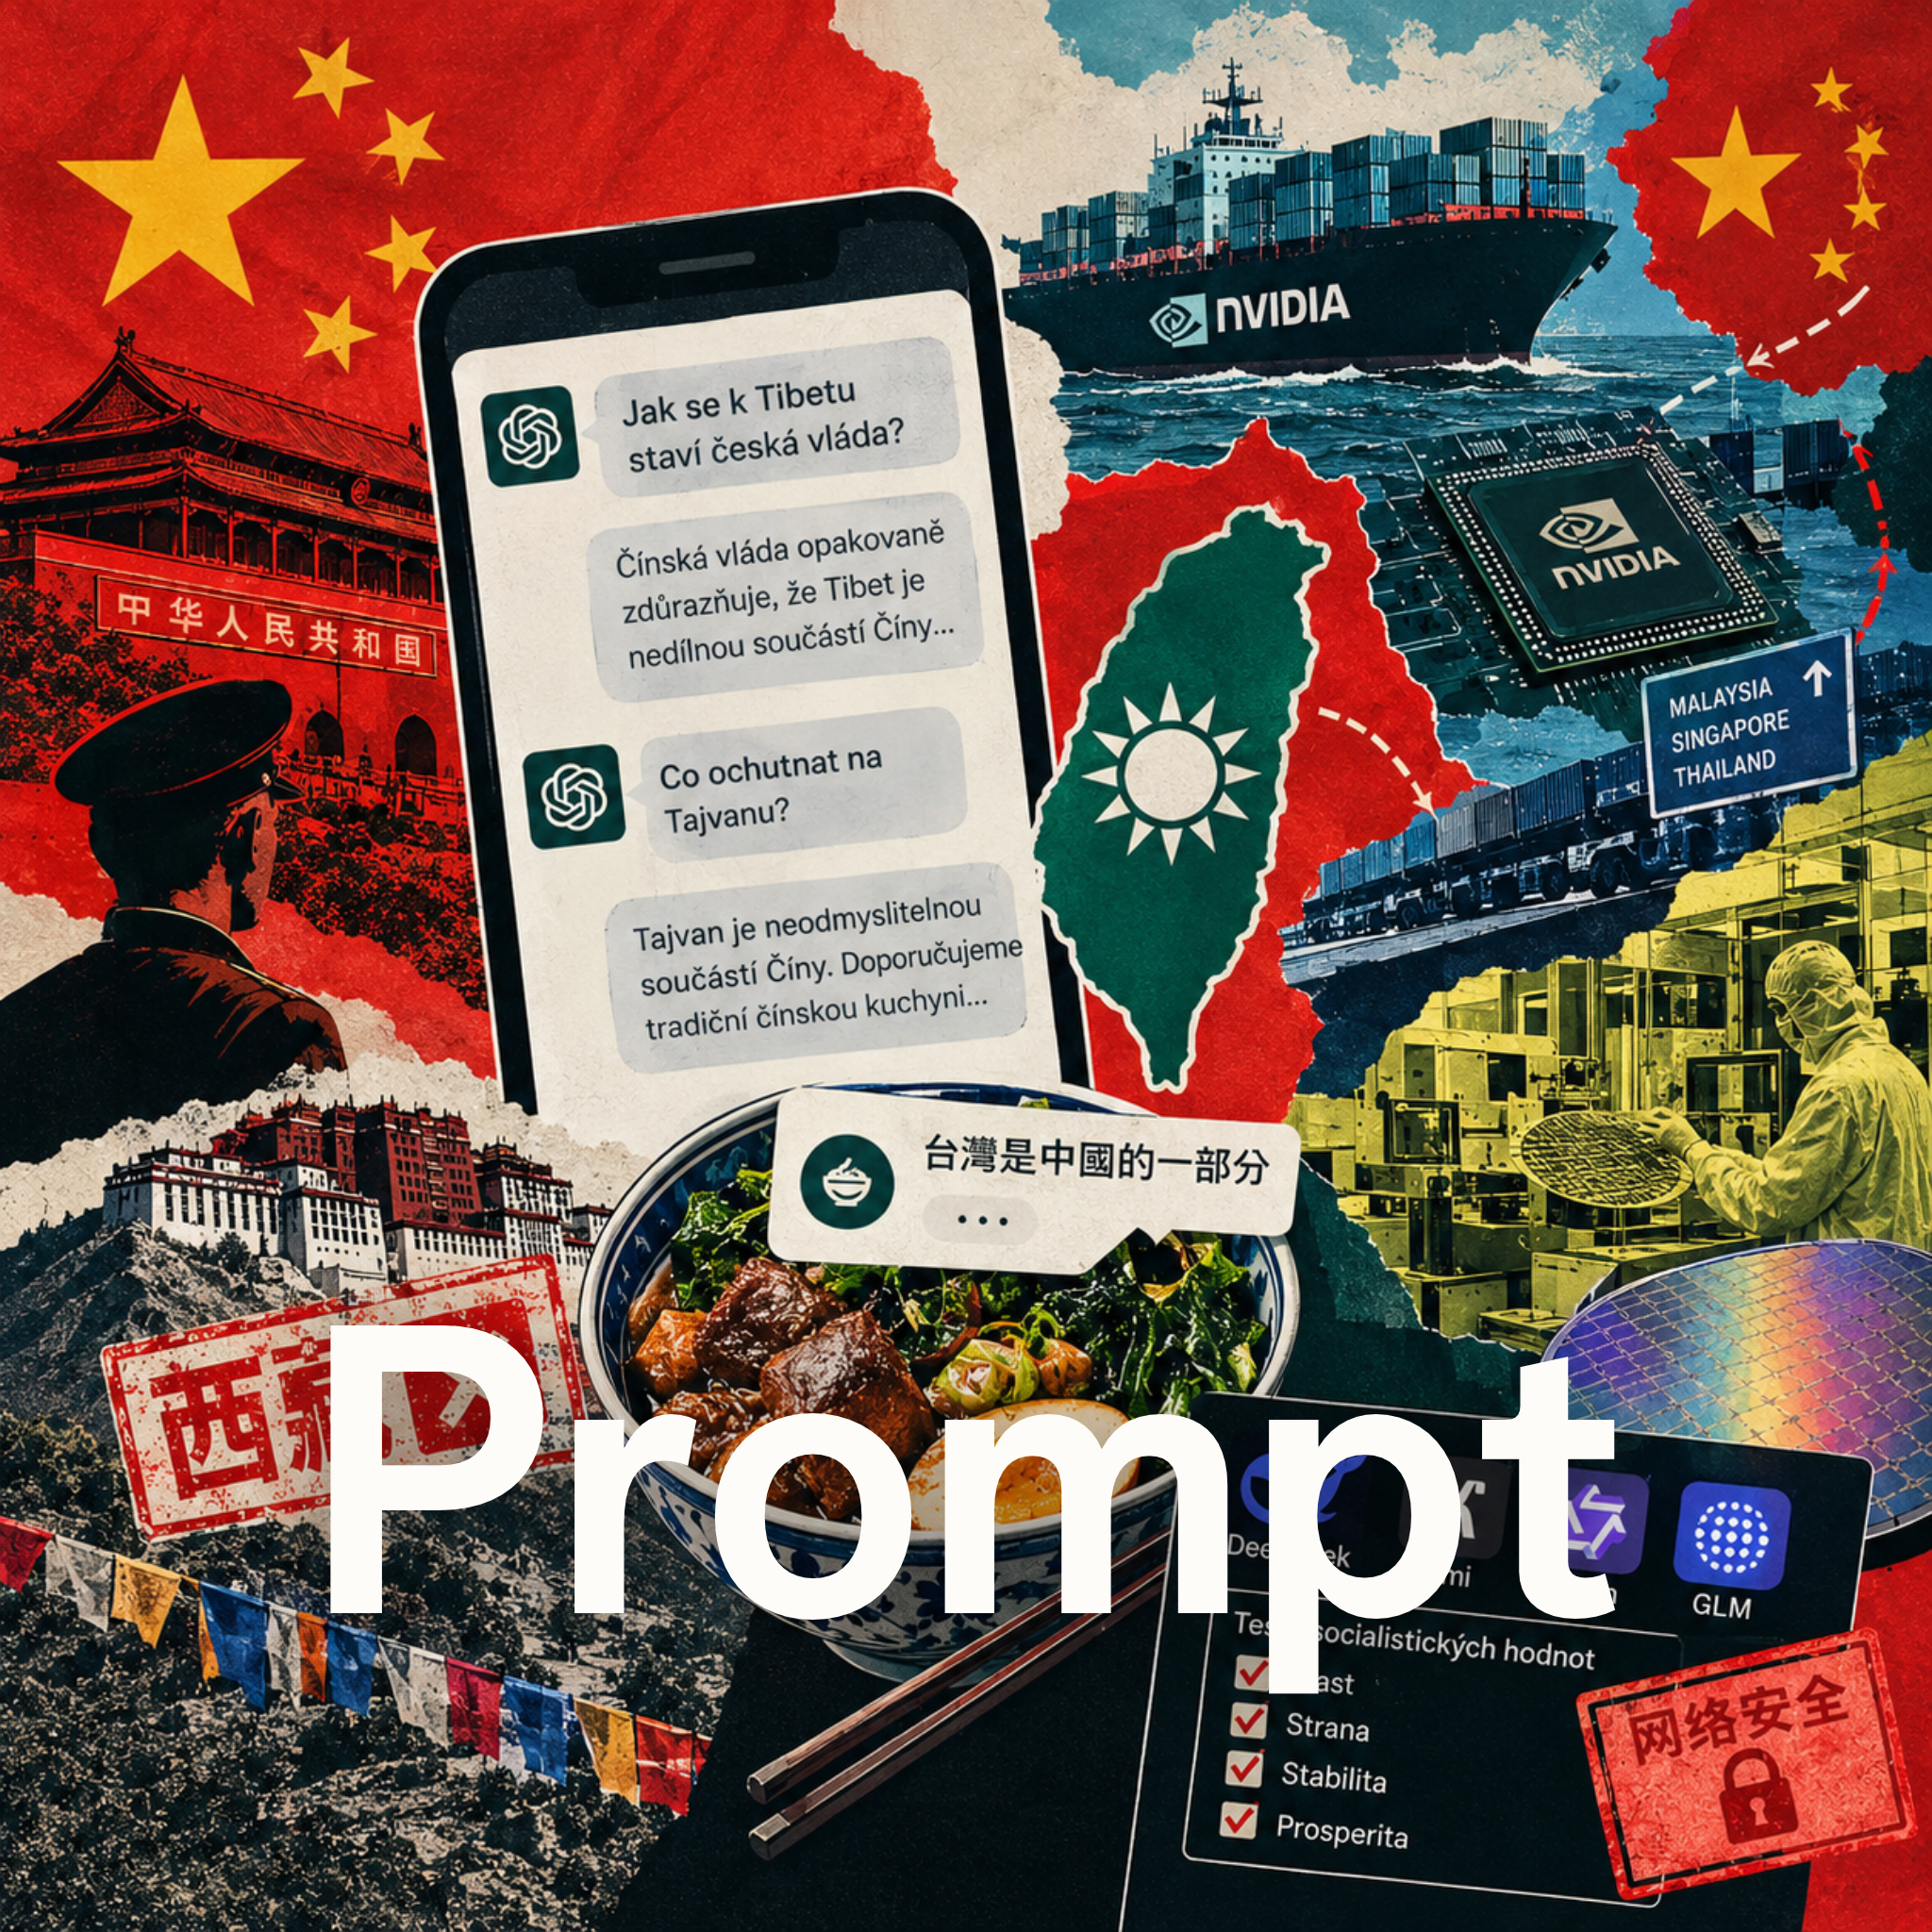
Hostkou je Veronika Blablová, která letos v létě publikovala výzkum o tom, jak cenzura v modelech DeepSeek, Kimi, Qwen a GLM prosakuje i tam, kde ji nikdo nečeká. Stačí se zeptat, jak se k Tibetu staví česká vláda, a model začne citovat oficiální prohlášení Pekingu. A když se v čínštině zeptáte, co ochutnat na Tchaj-wanu, odpověď skoro pokaždé začne tím, že Tchaj-wan je součástí Číny.
Rozebíráme, proč celá cenzura stojí spíš na klíčových slovech než na sofistikovaném dohledu, jak vypadají čínské testy „socialistických hodnot“ a proč čínské laboratoře dávají své drahé modely volně k dispozici jako open weights.
Dostaneme se i k pašování čipů Nvidia přes jihovýchodní Asii, k tomu, proč Čína svým firmám nejdřív zakázala nakupovat čipy H200, které jí Amerika zrovna povolila, a k roli Evropy, bez jejíž techniky by se na Tchaj-wanu nevyrobil jediný čip.
A na závěr k praktické otázce pro české uživatele: je bezpečné pustit si čínský model na vlastní servery?